
가치 반복과 정책 반복
정책 반복법 policy iteration
- 반복적 정책 평가법을 통해 주어진 정책의 상태 가치를 추정할 수는 있으나, 최적 정책을 찾을 수는 없음
- 반복적 정책 평가법을 통해 얻은 가치 함수로, 상태마다 가장 가치가 높은 행동을 하도록 정책을 개선
- argmaxa: 뒤의 수식을 가장 크게 만드는 a를 찾으라는 뜻
- 정책 평가와 정책 개선을 반복하여 더 이상 정책이 개선되지 않을 때까지 반복
정책 개선
def policy_improvement(V, P, gamma=1.0):
    nS = len(P)  # 상태의 수
    nA = len(P[0])  # 행동의 수
    Q = np.zeros((nS, nA))  # 행동가치함수
    for s in range(nS):
        for a in range(nA):
            for prob, next_state, reward, done in P[s][a]:
                Q[s][a] += prob * (reward + gamma * V[next_state] * (not done))
    new_pi = {s: a for s, a in enumerate(np.argmax(Q, axis=1))}
    return new_pi
axis
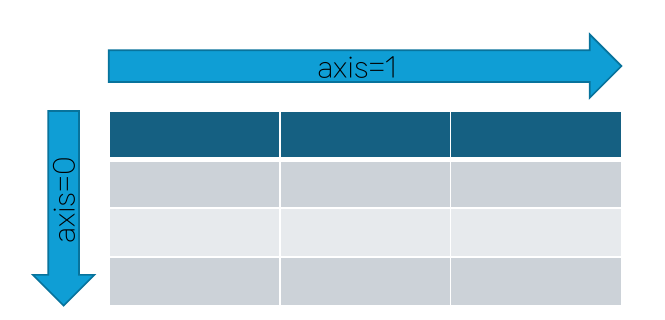
axis=1: 행마다 열 방향으로 계산axis=0: 열마다 행 방향으로 계산
정책 개선
- 평가된 가치를 바탕으로 정책 개선
improved_pi = policy_improvement(V, env.P)
improved_pi
- 개선된 정책의 평가
improved_V = policy_evaluation(improved_pi, env.P)
improved_V
정책 반복
- 정책 평가와 정책 개선을 반복해서 최적 정책을 찾는 방법
def policy_iteration(env, gamma=1.0, theta=1e-10):
    pi = random_policy(env)
    P = env.unwrapped.P
    while True:
        old_pi = dict(pi)
        V = policy_evaluation(pi, P, gamma, theta)
        pi = policy_improvement(V, P, gamma)
        if old_pi == pi:
            break  # 더이상 정책이 개선되지 않으면 중단
    return V, pi
무작위 정책
def random_policy(env):
    return {s: env.action_space.sample()
            for s in range(env.observation_space.n)}


policy_iteration(env)
가치 반복법 value iteration
- 정책 반복은 가치가 수렴될 때까지 추정을 한 다음에 정책을 최적화
- 가치 반복은 가치를 추정하는 중간 과정에 정책도 계속 최적화
- 현재까지 추정된 가치를 기준 vk를 기준으로, 가장 가치가 큰 행동을 하는 것으로 정책을 수정
- 이에 따라 추정된 가치도 vk+1로 수정
- 강화학습의 기본적인 아이디어
가치 반복
def value_iteration(env, gamma=1.0, theta=1e-10):
    P = env.unwrapped.P  # 전이 함수
    nS = env.observation_space.n  # 상태의 수
    nA = env.action_space.n  # 행동의 수
    V = np.zeros(nS)  # 상태 가치 함수
    while True:
        Q = np.zeros((nS, nA))  # 행동 가치 함수
        for s in range(nS):
            for a in range(nA):
                for prob, next_state, reward, done in P[s][a]:
                    Q[s][a] += prob * (reward + gamma * V[next_state] * (not done))
        if np.max(np.abs(V - np.max(Q, axis=1))) < theta:
            break
        pi = {s: a for s, a in enumerate(np.argmax(Q, axis=1))}  # 정책=가장 가치가 높은 행동
        V = np.max(Q, axis=1)  # 상태 가치도 맞춰서 업데이트
    return V, pi
가치 반복 실험
V, pi = value_iteration(env)
퀴즈
정책 반복법(policy iteration)의 핵심 흐름으로 가장 알맞은 것은 무엇입니까?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.